 EN
A interruptor redundante la configuración de redundancia es una de las estrategias más eficaces que un equipo de redes puede implementar para prevenir tiempos de inactividad costosos. Cuando un dispositivo de conmutación principal falla inesperadamente, un interruptor redundante asume automáticamente su función, manteniendo activas las rutas de datos y conservando los servicios empresariales críticos en línea sin necesidad de intervención manual. Comprender exactamente cómo funciona este proceso ayuda a los arquitectos de redes a tomar decisiones más inteligentes sobre la infraestructura.
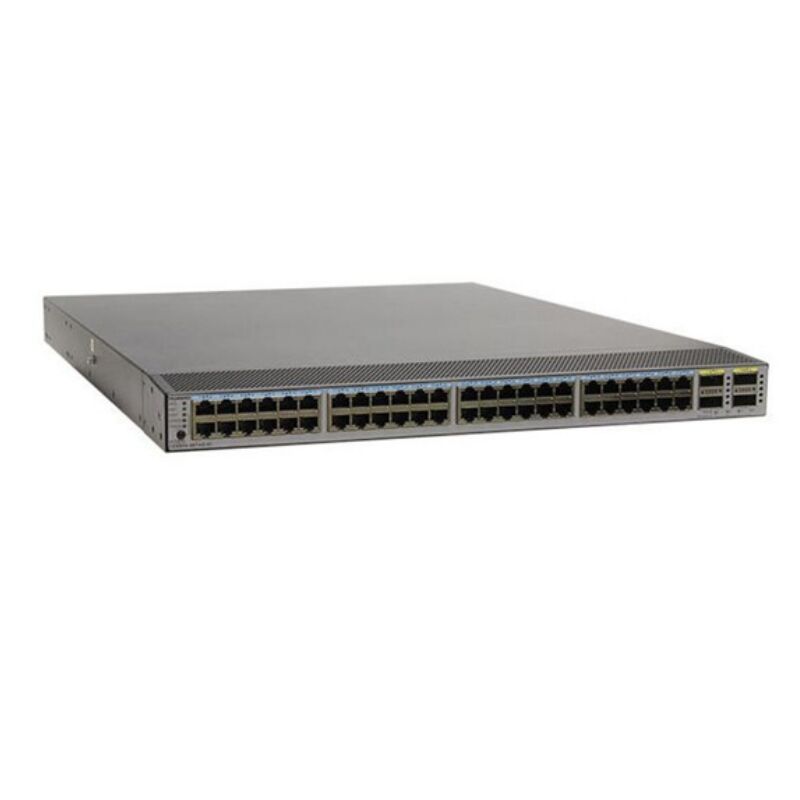
Todo centro de datos y toda red empresarial corren el riesgo de fallos de hardware. La implementación de un solo interruptor redundante puede marcar la diferencia entre una experiencia de usuario perfectamente fluida y varias horas de interrupción grave. Este artículo explora los mecanismos fundamentales detrás de las configuraciones de interruptores redundantes, cómo responden ante fallos de hardware y qué principios de diseño garantizan su funcionamiento fiable precisamente cuando más lo necesitan.
Mecanismos fundamentales de una configuración de interruptor redundante
Protocolos de conmutación por error que impulsan la redundancia
El fundamento de cualquier configuración de conmutador redundante radica en su pila de protocolos de conmutación por error. Tecnologías como el Protocolo de Árbol de Expansión Rápido (RSTP) y el Protocolo de Redundancia de Enrutadores Virtuales (VRRP) operan a nivel de protocolo para detectar, en cuestión de milisegundos, un fallo en un conmutador redundante y reenviar el tráfico en consecuencia. Cada conmutador redundante de la topología intercambia continuamente señales de estado con sus pares, de modo que, en el instante en que un dispositivo deja de responder, el conmutador redundante en espera asume inmediatamente el rol activo. Esta conmutación rápida es lo que hace tan valiosa una configuración de conmutador redundante en entornos productivos, donde incluso una interrupción de diez segundos tiene un impacto financiero cuantificable.
Más allá de las variantes del árbol de expansión, las implementaciones modernas de conmutadores redundantes suelen basarse en la agregación de enlaces de múltiples chasis, lo que permite que un par de conmutadores redundantes aparezca como un único dispositivo lógico para los hosts conectados. Cuando falla uno de los conmutadores físicos redundantes del par, el conmutador redundante superviviente continúa reenviando tráfico a través de todos los enlaces agregados sin ningún retraso por reconvergencia de la topología. Este enfoque hace que el par de conmutadores redundantes sea efectivamente invisible para las aplicaciones de capas superiores, reduciendo drásticamente el tiempo de recuperación en comparación con los diseños heredados basados en un único conmutador.
Redundancia a nivel de hardware dentro de un único conmutador redundante
Un interruptor redundante bien diseñado también incorpora mecanismos de redundancia interna independientes de los protocolos a nivel de red. Las fuentes de alimentación redundantes duales dentro del chasis de un interruptor redundante garantizan que la falla de una única unidad de alimentación no detenga todo el dispositivo. Las tarjetas de línea intercambiables en caliente en un interruptor redundante modular permiten a los equipos de campo reemplazar un módulo de puertos fallido sin apagar el chasis, preservando así el reenvío continuo para todos los demás dispositivos conectados. Estas características internas complementan el emparejamiento externo de interruptores redundantes, creando una protección en capas en cada punto de fallo potencial.
Cómo responde un interruptor redundante durante una falla activa de hardware
Secuencia de detección, decisión y conmutación
Cuando se produce un evento de fallo de hardware, una configuración de conmutador redundante sigue una secuencia precisa de detección y conmutación. En primer lugar, el conmutador redundante activo deja de enviar mensajes de supervivencia (keepalive) a su homólogo en espera. El conmutador redundante en espera detecta esta ausencia de comunicación dentro de un intervalo muerto configurable, normalmente inferior a un segundo en despliegues bien ajustados. Una vez que el conmutador redundante en espera confirma el fallo, asume el rol activo y comienza a procesar todo el tráfico entrante y saliente. Toda la secuencia de conmutación redundante, desde la detección del fallo hasta la reanudación completa de la transmisión de tráfico, puede completarse en menos de tres segundos en topologías optimizadas, lo que la hace prácticamente transparente para los usuarios finales.
Tras el cambio de conmutación, el interruptor redundante anteriormente activo se reinicia automáticamente o espera en un estado de retención de preemption, según la política de configuración. La configuración de preemption en un interruptor redundante determina si el dispositivo primario original recupera el rol activo una vez que se recupera, o si el interruptor redundante actualmente activo mantiene el control para evitar una segunda interrupción. Los arquitectos de redes deben evaluar cuidadosamente el momento de la preemption en los interruptores redundantes para evitar oscilaciones (flapping) durante condiciones inestables del hardware.
Restauración de la ruta de tráfico y sincronización de estado
Una capacidad crítica de una plataforma avanzada de conmutador redundante es el cambio de estado (stateful switchover), en el que el conmutador redundante en espera mantiene una copia sincronizada en tiempo real de la tabla de reenvío y del estado de las sesiones del conmutador redundante activo. Cuando se produce el cambio, el conmutador redundante recién activado no necesita reconstruir desde cero su tabla de direcciones MAC ni su información de enrutamiento. En su lugar, el conmutador redundante inicia inmediatamente el reenvío de tráfico utilizando el estado previamente sincronizado, eliminando así la breve interrupción del reenvío que experimentaban los diseños anteriores de conmutadores redundantes sin capacidad de estado. Esta capacidad de sincronización resulta especialmente importante en entornos de centros de datos que ejecutan cargas de trabajo sensibles a la latencia, donde incluso un retraso parcial en la reconvergencia del conmutador redundante podría provocar tiempos de espera en las aplicaciones.
Principios de diseño para una arquitectura fiable de conmutador redundante
Planificación de topología y diversidad de enlaces
Implementar un conmutador redundante es solo el primer paso. La topología circundante debe diseñarse para eliminar los puntos únicos de fallo que podrían anular la ventaja del conmutador redundante. Cada conmutador redundante debe conectarse a dispositivos ascendentes mediante enlaces ascendentes físicamente diversos, que sigan rutas distintas a través de bandejas de cables, tubos y paneles de parcheo diferentes. Si ambos enlaces ascendentes de un conmutador redundante comparten la misma ruta física, un único corte de cable desactiva por completo la protección del conmutador redundante. Una planificación adecuada de la topología del conmutador redundante requiere coordinación con los equipos de instalaciones para garantizar una verdadera diversidad de rutas en cada capa de la infraestructura.
Los equipos de red también deberían considerar la ubicación de cada conmutador redundante en relación con las unidades de distribución de energía y las zonas de refrigeración. Un par de conmutadores redundantes ubicado en el mismo rack y alimentado por la misma UDE pierde gran parte de su valor protector durante un evento de fallo eléctrico. La mejor práctica consiste en colocar cada conmutador redundante en un rack separado, en un circuito de alimentación independiente y dentro de una zona aislada de fallos en la planta del centro de datos.
Pruebas y validación de la conmutación automática redundante
Una configuración de conmutador redundante que nunca se ha probado en condiciones realistas de fallo ofrece una garantía limitada. Las pruebas programadas de conmutación por fallo obligan deliberadamente a desconectar el conmutador redundante activo, lo que permite al equipo medir los tiempos reales de conmutación e identificar cualquier dependencia oculta que pueda ralentizar el proceso de recuperación del conmutador redundante. Las herramientas automatizadas de supervisión deben seguir continuamente las métricas de salud del conmutador redundante, alertando a los ingenieros antes de que un evento de degradación hardware se agrave hasta convertirse en un fallo total del conmutador redundante. La validación periódica mantiene la configuración del conmutador redundante en un estado conocido como bueno y refuerza la confianza del equipo en la arquitectura.
Preguntas frecuentes
¿Cuál es la diferencia entre un conmutador redundante y un conmutador estándar?
Un interruptor estándar funciona como un dispositivo individual sin contraparte de conmutación por error. Una configuración de interruptor redundante combina dos o más interruptores de modo que, si uno de los dispositivos falla, otro asume automáticamente su función. El enfoque del interruptor redundante elimina el único punto de fallo que representa un interruptor independiente, lo cual es fundamental en entornos donde la disponibilidad de la red afecta directamente a las operaciones empresariales.
¿Con qué rapidez se produce la conmutación por error en un interruptor redundante?
Con protocolos correctamente configurados y con la conmutación por error con estado habilitada, la conmutación por error de un interruptor redundante puede completarse en menos de tres segundos y, a menudo, en cuestión de milisegundos para eventos a nivel de enlace. El tiempo exacto de recuperación del interruptor redundante depende de la configuración del intervalo muerto, de los temporizadores de los protocolos y de si el interruptor redundante en espera mantiene un estado de reenvío sincronizado con la unidad activa.
¿Es adecuada una configuración de interruptor redundante para redes pequeñas?
Una configuración redundante de conmutadores se implementa comúnmente en centros de datos empresariales y en las capas principales de campus, donde los requisitos de tiempo de actividad son estrictos. Sin embargo, redes más pequeñas con aplicaciones críticas también pueden beneficiarse de un par de conmutadores redundantes en su capa de distribución o principal. Normalmente, la inversión en conmutadores redundantes está justificada cuando el impacto financiero del tiempo de inactividad supera los costes asociados al hardware y a la sobrecarga de configuración.